概览
- 工具名称:LLaMA
- 开发方:GitHub
- 官方网站:https://github.com/facebookresearch/llama
- 工具定位:AI 训练模型
LLaMA 是 Meta 推出的开源大语言模型家族,面向研究与开发场景提供模型推理代码。它可用于文本补全、对话生成等自然语言任务,并支持开发者在本地或自有环境中部署和调试。该仓库包含示例脚本与依赖配置,便于快速上手。
主要用途
- 提供 Llama 模型的推理代码,支持文本补全与对话生成两类基础任务,开发者可直接运行示例脚本验证模型输出。
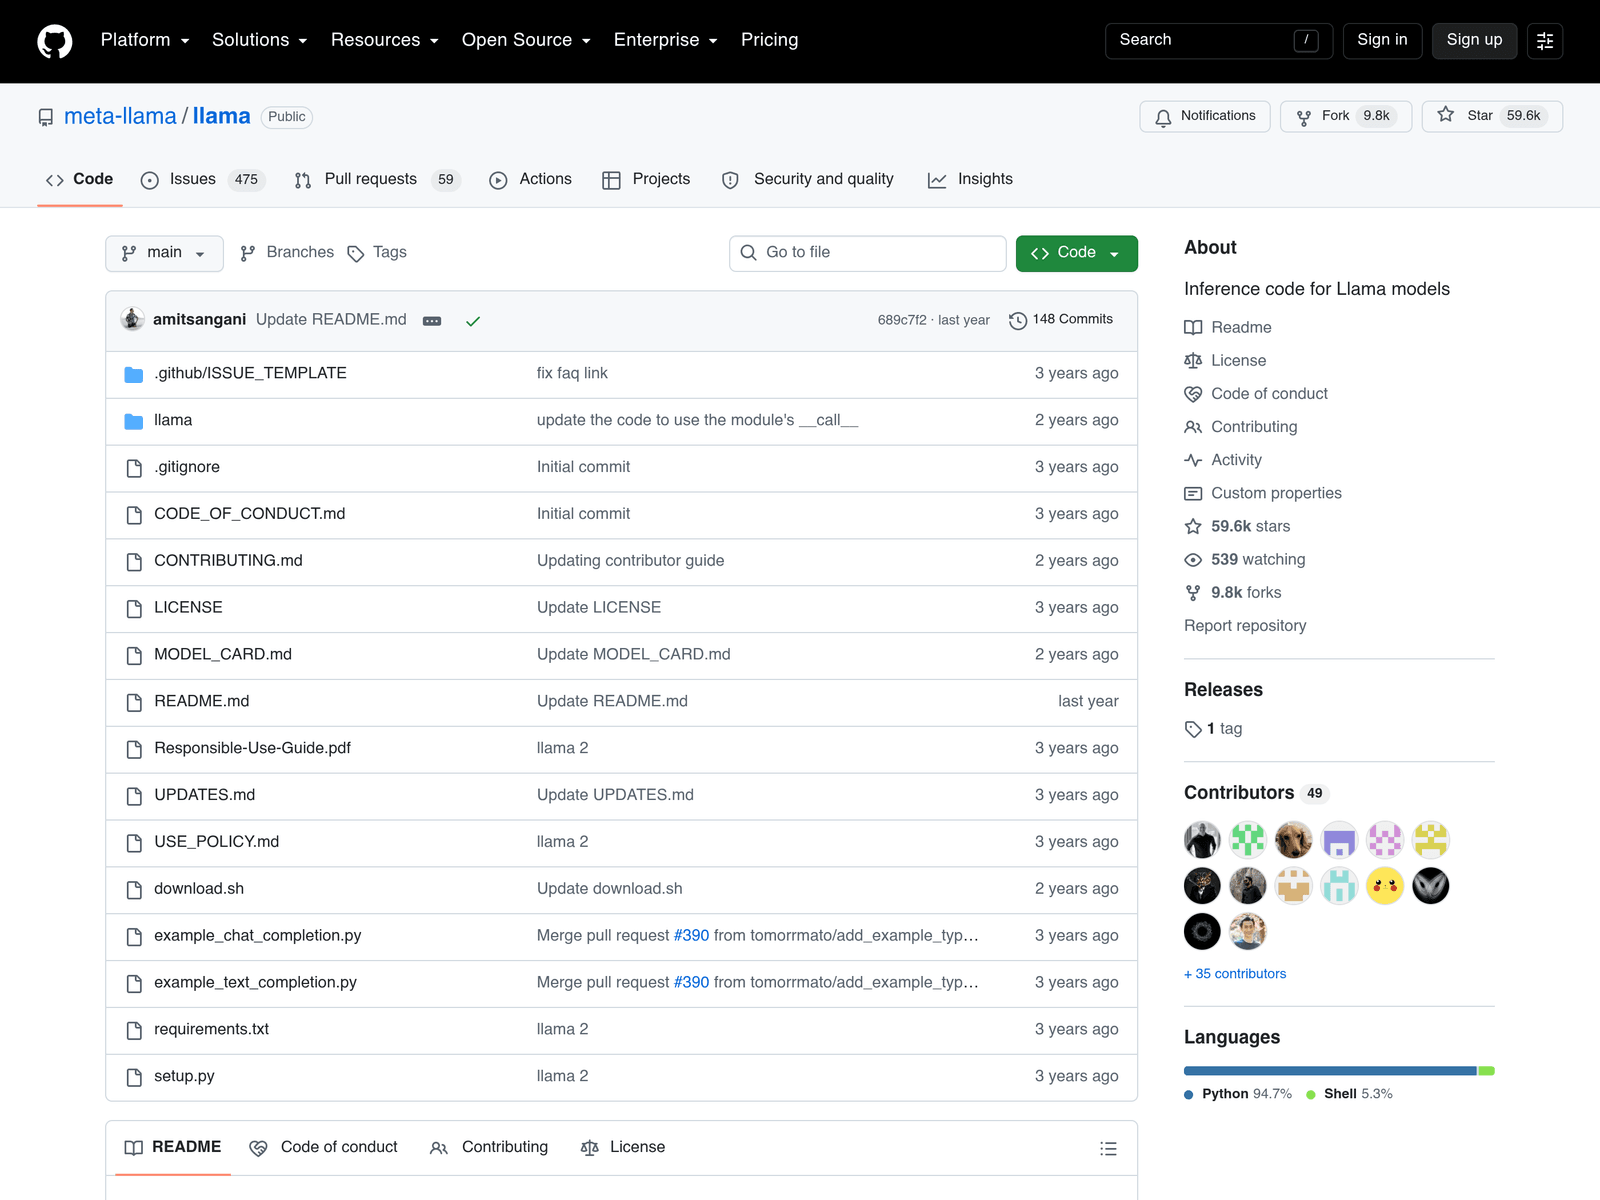
- 仓库内置 example_chat_completion.py 与 example_text_completion.py,分别对应聊天与文本补全场景,便于快速区分不同调用方式。
- 通过 requirements.txt 与 setup.py 管理依赖,用户可在本地环境安装所需包,降低部署门槛。
- 包含 MODEL_CARD.md 与 Responsible-Use-Guide.pdf,为模型使用提供背景说明与责任使用指引,辅助合规评估。
- 提供 download.sh 脚本,用于获取模型权重,简化下载流程,避免手动查找资源路径。
适用场景
- 研究人员可基于该仓库复现 Llama 模型的基础推理能力,用于自然语言处理实验与基准测试。
- 开发者可将其作为起点构建本地化语言应用,如客服机器人、文档摘要工具或知识问答系统。
- 教育机构可用于教学演示,展示大语言模型的加载、推理与提示工程基本流程。
- 企业技术团队可评估模型在内部业务中的适配性,结合自有数据进行微调或集成测试。
使用建议
- 先阅读 README.md 与 UPDATES.md 了解当前支持的功能与已知限制,避免使用已弃用接口。
- 运行前确保 Python 环境满足 requirements.txt 所列依赖,建议使用虚拟环境隔离项目依赖。
- 若需访问 Hugging Face 上的模型资源,请提前注册账号并完成必要授权流程。
- 参考 Responsible-Use-Guide.pdf 中的指引,评估输出内容的安全性与适用边界,避免高风险场景误用。
局限与注意事项
- 仓库标注“(Deprecated) Llama 2”,表明部分旧版模型或接口可能不再维护,新项目应优先采用最新推荐方案。
- 仅提供推理代码,不包含训练流程或微调脚本,若需定制模型需自行补充训练管线。
- 模型权重需通过 download.sh 或 Hugging Face 获取,可能涉及访问权限或地区限制,需提前确认网络与账号条件。
常见问题
如何开始使用 LLaMA?
首先克隆仓库并安装 requirements.txt 中的依赖,然后运行 download.sh 获取模型权重。接着根据任务类型选择 example_chat_completion.py 或 example_text_completion.py 进行测试。建议先阅读 README.md 了解环境配置要求。
LLaMA 是否免费?
仓库代码本身开源免费,但模型权重的获取可能受 Meta 的使用政策约束。部分资源需通过 Hugging Face 访问,具体授权条款以官方页面显示为准。
LLaMA 支持哪些平台?
代码基于 Python 编写,可在支持 Python 的操作系统上运行,包括 Linux、macOS 和 Windows。实际性能取决于硬件配置,尤其是 GPU 或加速卡支持情况。
LLaMA 与其他开源大模型有何区别?
LLaMA 由 Meta 推出,以开放权重和高效推理著称,适合研究与二次开发。相比闭源模型,它提供更高透明度与可控性;但相比某些全功能框架,本仓库仅聚焦推理,不含训练组件。
有没有 LLaMA 的替代方案?
类似定位的开源模型包括 Mistral、Qwen 和 Llama 3 系列。选择时可依据任务需求、硬件条件及许可证条款进行评估。部分平台也提供托管式 API 作为本地部署的替代。