概覽
- 工具名稱:LLaMA
- 開發方:GitHub
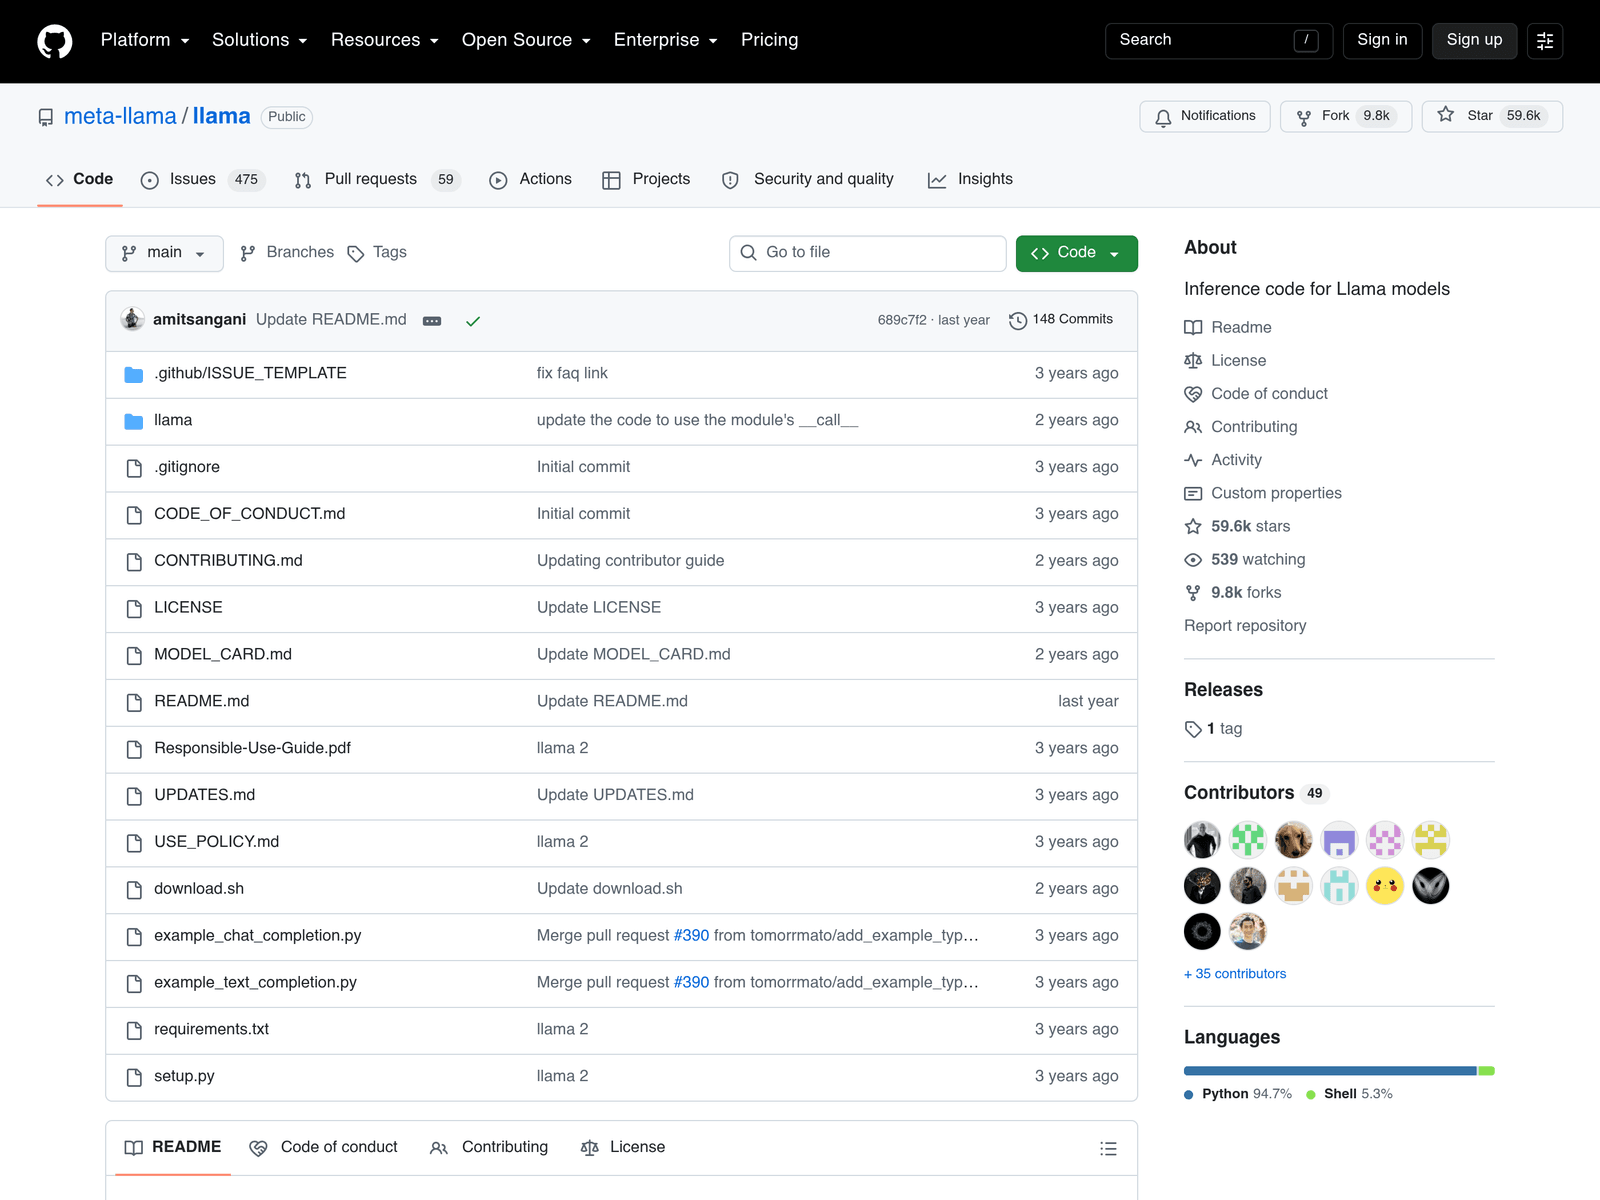
- 官方網站:https://github.com/facebookresearch/llama
- 工具定位:AI 訓練模型
LLaMA 是 Meta 推出的開源大語言模型家族,面向研究與開發場景提供模型推理程式碼。它可用於文本補全、對話生成等自然語言任務,並支援開發者在本地或自有環境中部署和除錯。該倉庫包含示例指令碼與依賴配置,便於快速上手。
主要用途
- 提供 Llama 模型的推理程式碼,支援文本補全與對話生成兩類基礎任務,開發者可直接執行示例指令碼驗證模型輸出。
- 倉庫內建 example_chat_completion.py 與 example_text_completion.py,分別對應聊天與文本補全場景,便於快速區分不同調用方式。
- 通過 requirements.txt 與 setup.py 管理依賴,使用者可在本地環境安裝所需包,降低部署門檻。
- 包含 MODEL_CARD.md 與 Responsible-Use-Guide.pdf,為模型使用提供背景說明與責任使用指引,輔助合規評估。
- 提供 download.sh 指令碼,用於獲取模型權重,簡化下載流程,避免手動查詢資源路徑。
適用場景
- 研究人員可基於該倉庫復現 Llama 模型的基礎推理能力,用於自然語言處理實驗與基準測試。
- 開發者可將其作為起點構建本地化語言應用,如客服機器人、文件摘要工具或知識問答系統。
- 教育機構可用於教學演示,展示大語言模型的載入、推理與提示工程基本流程。
- 企業技術團隊可評估模型在內部業務中的適配性,結合自有資料進行微調或整合測試。
使用建議
- 先閱讀 README.md 與 UPDATES.md 瞭解當前支援的功能與已知限制,避免使用已棄用介面。
- 執行前確保 Python 環境滿足 requirements.txt 所列依賴,建議使用虛擬環境隔離專案依賴。
- 若需訪問 Hugging Face 上的模型資源,請提前註冊賬號並完成必要授權流程。
- 參考 Responsible-Use-Guide.pdf 中的指引,評估輸出內容的安全性與適用邊界,避免高風險場景誤用。
侷限與注意事項
- 倉庫標註“(Deprecated) Llama 2”,表明部分舊版模型或介面可能不再維護,新專案應優先採用最新推薦方案。
- 僅提供推理程式碼,不包含訓練流程或微調指令碼,若需定製模型需自行補充訓練管線。
- 模型權重需通過 download.sh 或 Hugging Face 獲取,可能涉及訪問許可權或地區限制,需提前確認網路與賬號條件。
常見問題
如何開始使用 LLaMA?
首先克隆倉庫並安裝 requirements.txt 中的依賴,然後執行 download.sh 獲取模型權重。接著根據任務型別選擇 example_chat_completion.py 或 example_text_completion.py 進行測試。建議先閱讀 README.md 瞭解環境配置要求。
LLaMA 是否免費?
倉庫程式碼本身開源免費,但模型權重的獲取可能受 Meta 的使用政策約束。部分資源需通過 Hugging Face 訪問,具體授權條款以官方頁面顯示為準。
LLaMA 支援哪些平臺?
程式碼基於 Python 編寫,可在支援 Python 的作業系統上執行,包括 Linux、macOS 和 Windows。實際效能取決於硬體配置,尤其是 GPU 或加速卡支援情況。
LLaMA 與其他開源大模型有何區別?
LLaMA 由 Meta 推出,以開放權重和高效推理著稱,適合研究與二次開發。相比閉源模型,它提供更高透明度與可控性;但相比某些全功能框架,本倉庫僅聚焦推理,不含訓練元件。
有沒有 LLaMA 的替代方案?
類似定位的開源模型包括 Mistral、Qwen 和 Llama 3 系列。選擇時可依據任務需求、硬體條件及許可證條款進行評估。部分平臺也提供託管式 API 作為本地部署的替代。